記事ディレクトリ
Baidu Spider は異常な情報をクロールして診断します: ソケットが読み書きされている場合はどうすればよいですか?
あなたの Web サイトが Baidu に含まれていないと仮定すると、まず、Baidu 検索リソース プラットフォームでスパイダー クロールの診断を実行する必要があります。
Baidu クローラーが診断リンクのクロールに失敗した場合はどうすればよいですか?
Baidu クローラーが何度もクロールと診断に失敗する場合は、ファイアウォールがクローラーをブロックしている可能性があります。
Baidu検索リソースプラットフォーム > クロール診断 > クロールエラー情報:ソケットの読み書きエラー ▼

- 特に使用してCloudFlare CDNを使用する場合、デフォルトではブロックされます。
- インターネット上では、IPアドレスを追加するという話があります
xxx.xxx.xxx.xxx/24 - しかし、無駄にしようとしました。
サーバーで Baidu スパイダーをブロックしていないので、問題は Cloudflare の WAF にあるはずです。
Cloudflareにサインイン → セキュリティ → WAF → ファイアウォール ルール → ファイアウォール ルールの作成
- Cloudflareでクローラー関連のWAFルールを探していたら「Legal Robot Crawler」という選択肢が見つかりました▼

- ファイアウォール ルールを作成した後、10 分待ってから診断を取得すると、すべて正常に取得されます。
Baidu クローラー サイトマップのクロールに失敗しました。接続がタイムアウトしましたか?
百度の検索リソースプラットフォームでサイトマップファイルのアドレスを送信すると、クローリングの失敗や接続タイムアウトの問題が発生 ▼

バイドゥ クローラーがサイトマップ マップ ソリューションをクロールできませんでした
Cloudflareにサインイン → セキュリティ → WAF → ファイアウォールルール → ファイアウォールルールの作成 ▼
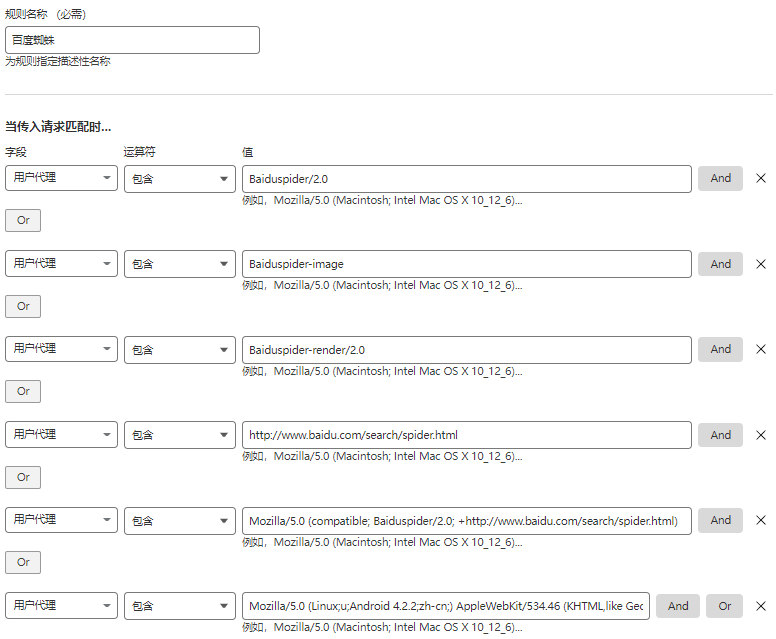
- フィールドで、ユーザーエージェントを選択します
- 演算子、「含む」を選択
- 新しいユーザー エージェントを追加し、最後に [または] をクリックします。
- 次の Baidu Spider UA ユーザー エージェントをそれぞれ入力します。
-
Baiduspider/2.0 -
Baiduspider-image -
Baiduspider-render/2.0 -
http://www.baidu.com/search/spider.html -
Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html) -
Mozilla/5.0 (Linux;u;Android 4.2.2;zh-cn;) AppleWebKit/534.46 (KHTML,like Gecko) Version/5.1 Mobile Safari/10600.6.3 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)
完了後、再度テストしてフェッチすると、結果は HTTP ヘッダー 200 を返し、フェッチが成功したことを示します▼
-
抓取诊断 > 抓取详情以下是百度Spider抓取结果及页面信息: -
提交网址: https://www.etufo.org/sitemap_baidu.xml -
抓取网址: https://www.etufo.org/sitemap_baidu.xml -
抓取UA: Mozilla/5.0 (compatible; Baiduspider/2.0; -
+http://www.baidu.com/search/spider.html) -
抓取时间: 2022-11-11 19:03:44 -
网站IP: 172.***.***.149 -
下载时长: 0.868秒 -
返回HTTP头:HTTP/2 200
他のスパイダーやクローラーのユーザーエージェントも同様に自分自身を検索できます。
Chen Weiliang氏のブログ(https://www.chenweiliang.com/ )に掲載されている記事「ソケットの読み書きエラーと接続タイムアウトへの対処法」が、皆様のお役に立てば幸いです。
この記事のリンクはご自由に共有してください:https://www.chenweiliang.com/cwl-29315.html