
लेख निर्देशिका
Baidu Spider निदान अपवाद माहिती कॅप्चर करते: सॉकेट चुकीचे वाचत आणि लिहित असल्यास मी काय करावे?
तुमची वेबसाइट Baidu द्वारे समाविष्ट केलेली नाही असे गृहीत धरून, तुम्ही प्रथम Baidu शोध संसाधन प्लॅटफॉर्मवर स्पायडर क्रॉलिंग निदान करणे आवश्यक आहे.
Baidu क्रॉलर डायग्नोस्टिक लिंक क्रॉल करण्यात अयशस्वी झाल्यास मी काय करावे?
Baidu क्रॉलर क्रॉल निदान अनेक वेळा अयशस्वी झाल्यास, फायरवॉलने क्रॉलर प्रोग्राम अवरोधित केला असेल.
बायडू सर्च रिसोर्स प्लॅटफॉर्म > क्रॉलिंग डायग्नोस्टिक्स > क्रॉलिंग त्रुटी माहिती: सॉकेट रीड/राइट त्रुटी ▼

- विशेषतः वापरणेCloudflare CDN वापरताना, ते पूर्वनिर्धारितपणे अवरोधित केलेले असते.
- इंटरनेटवर, आयपी अॅड्रेस जोडण्यास सांगितले जाते
xxx.xxx.xxx.xxx/24 - मात्र, तसा प्रयत्न करूनही उपयोग झाला नाही.
मी Baidu स्पायडरना सर्व्हरवर ब्लॉक केले नाही, त्यामुळे समस्या Cloudflare च्या WAF ची असावी!
Cloudflare → सुरक्षा → WAF → फायरवॉल नियम → फायरवॉल नियम तयार करा वर लॉगिन करा
- Cloudflare वर क्रॉलर्सशी संबंधित WAF नियम शोधा आणि "कायदेशीर रोबोट क्रॉलर" चा पर्याय सापडला ▼

- फायरवॉल नियम तयार केल्यानंतर, 10 मिनिटे प्रतीक्षा करा, आणि नंतर निदान पकडा आणि ते सर्व यशस्वीरित्या कॅप्चर केले गेले!
Baidu क्रॉलर साइटमॅप क्रॉलिंग अयशस्वी आणि कनेक्शन टाइमआउटमध्ये काय चूक आहे?
तुम्ही Baidu शोध संसाधन प्लॅटफॉर्मवर साइटमॅप फाइलचा पत्ता सबमिट केल्यास, क्रॉलिंग अयशस्वी आणि कनेक्शन कालबाह्य यासारख्या समस्या असतील ▼

साइटमॅप नकाशा हस्तगत करण्यात Baidu क्रॉलरच्या अपयशाचे समाधान
Cloudflare → सुरक्षा → WAF → फायरवॉल नियम → फायरवॉल नियम तयार करा ▼ वर लॉग इन करा
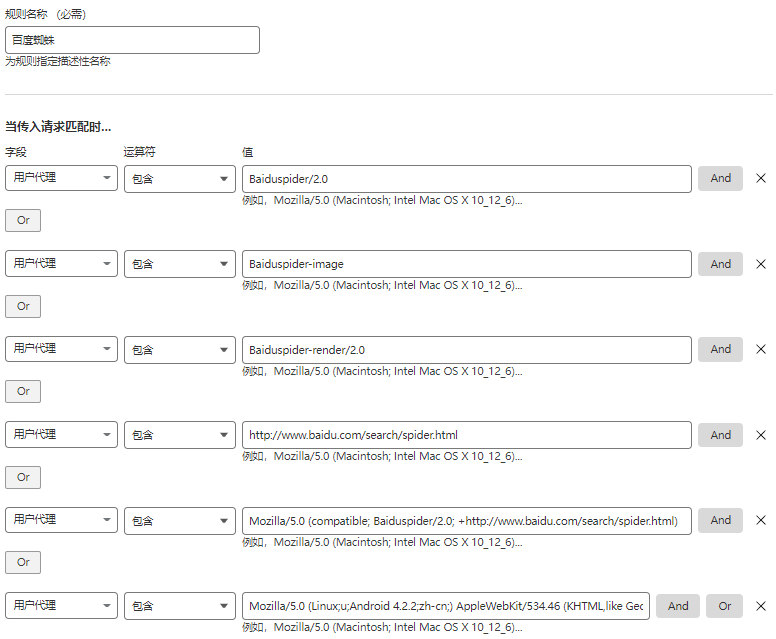
- फील्ड, "वापरकर्ता एजंट" निवडा
- ऑपरेटर, समाविष्ट आहे निवडा
- नवीन वापरकर्ता एजंट जोडा, शेवटचे "किंवा" क्लिक करा
- मूल्य, अनुक्रमे खालील Baidu Spider UA वापरकर्ता एजंट प्रविष्ट करा:
-
Baiduspider/2.0 -
Baiduspider-image -
Baiduspider-render/2.0 -
http://www.baidu.com/search/spider.html -
Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html) -
Mozilla/5.0 (Linux;u;Android 4.2.2;zh-cn;) AppleWebKit/534.46 (KHTML,like Gecko) Version/5.1 Mobile Safari/10600.6.3 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)
पूर्ण झाल्यानंतर, फेचिंगची पुन्हा चाचणी करा आणि परिणाम HTTP शीर्षलेख 200 परत करेल, हे दर्शविते की आणणे यशस्वी झाले आहे▼
-
抓取诊断 > 抓取详情以下是百度Spider抓取结果及页面信息: -
提交网址: https://www.etufo.org/sitemap_baidu.xml -
抓取网址: https://www.etufo.org/sitemap_baidu.xml -
抓取UA: Mozilla/5.0 (compatible; Baiduspider/2.0; -
+http://www.baidu.com/search/spider.html) -
抓取时间: 2022-11-11 19:03:44 -
网站IP: 172.***.***.149 -
下载时长: 0.868秒 -
返回HTTP头:HTTP/2 200
इतर स्पायडर आणि क्रॉलर्सचे वापरकर्ता एजंट देखील त्याच प्रकारे स्वतःचा शोध घेऊ शकतात.
आशा आहे की, चेन वेइलियांगच्या ब्लॉगवर ( https://www.chenweiliang.com/ ) शेअर केलेला "सॉकेट रीड/राइट एरर्स आणि कनेक्शन टाइमआउट्स कसे हाताळावे" हा लेख तुम्हाला उपयुक्त ठरेल.
या लेखाची लिंक शेअर करण्यास हरकत नाही: https://www.chenweiliang.com/cwl-29315.html