ဆောင်းပါးလမ်းညွှန်
မကြာသေးခင်က ဝက်ဘ်ဆိုက် backend ကို စစ်ဆေးကြည့်တော့ ပျမ်းမျှနေ့စဉ်လာရောက်လည်ပတ်မှုအရေအတွက်က ထောင်ဂဏန်းအနည်းငယ်သာရှိပါတယ်။
Google Analytics ကို ဖွင့်လိုက်တဲ့အခါ ကျွန်တော် လုံးဝ အံ့အားသင့်သွားတယ်။
တစ်နေ့မှာ ကျွန်တော့်ရဲ့ စာမျက်နှာကြည့်ရှုမှုအရေအတွက်ဟာ ရုတ်တရက် ၂၀,၀၀၀ ကျော်အထိ မြင့်တက်လာခဲ့ပြီး နောက်ဆုံးတော့ နာမည်ကြီးလာပြီလို့ ထင်ခဲ့မိလို့ အရမ်းပျော်နေမိပါတယ်။ ဒါပေမယ့် browser distribution ကို သေချာစစ်ဆေးကြည့်တဲ့အခါ traffic ရဲ့ ၉၀% ဟာ "HeadlessChrome" လို့ခေါ်တဲ့ website ကနေ လာတာကို တွေ့ရှိခဲ့ပါတယ်။
ဒါက ဘာဘရောက်ဆာလဲလို့ ChatGTP ကို မေးလိုက်တယ်။ Chrome ရဲ့ ဗားရှင်းအသစ်လား။
AI က ဒါဟာ browser မဟုတ်ဘူးလို့ တုံ့ပြန်ခဲ့ပါတယ်။
ဒါက ရိုဘော့ပါ။
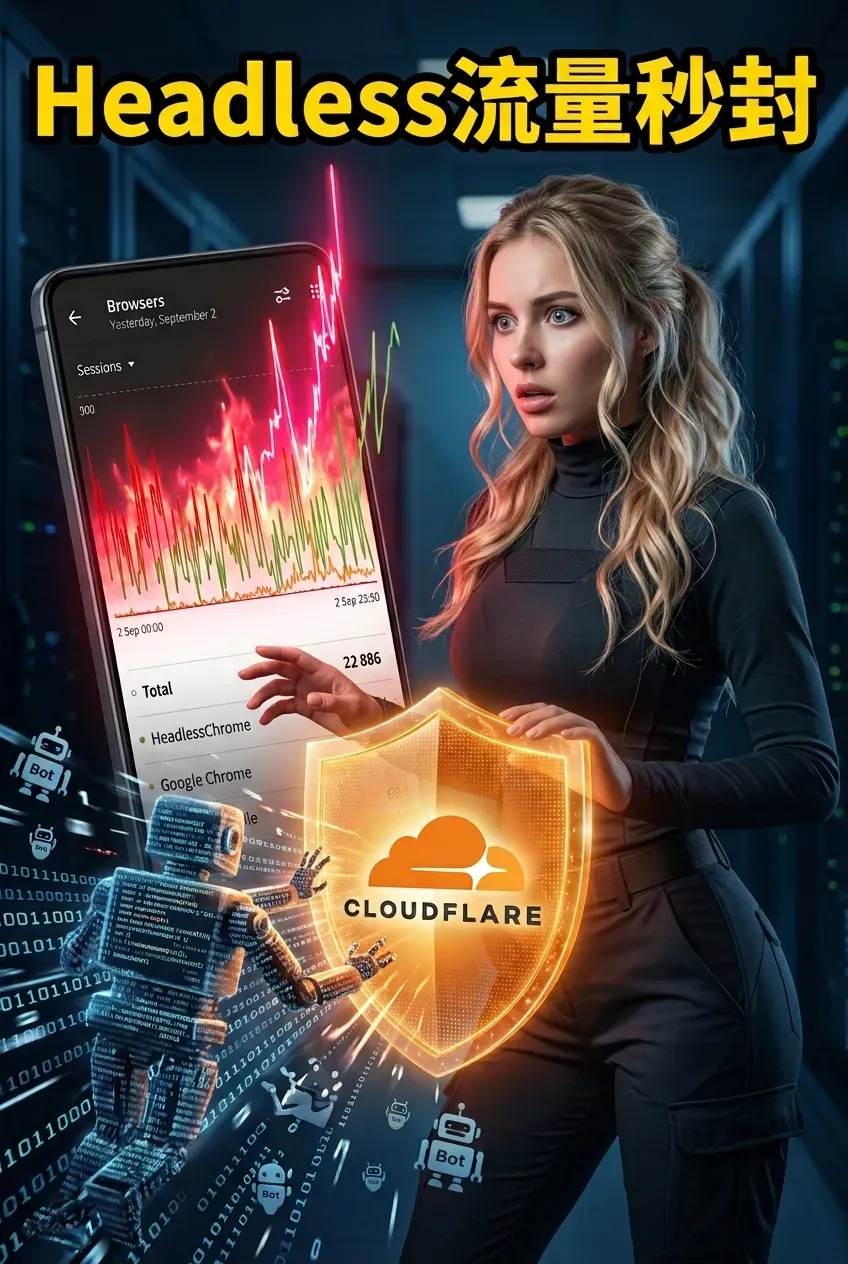
HeadlessChrome ဆိုတာ အတိအကျ ဘာလဲ။
HeadlessChrome ဆိုတာ နာမည်အတိုင်းပါပဲ၊ Chrome ရဲ့ headless mode ပါ။ Chrome က နေ့တိုင်းသုံးတဲ့ browser ပါ။ Headless mode က browser ရဲ့ graphical interface ကို disable လုပ်ထားပြီး command line ကိုပဲသုံးပြီး background မှာ run နိုင်အောင် လုပ်ပေးပါတယ်။
လိပ်စာဘား၊ စာညှပ်ဘား၊ သင်မြင်နိုင်တဲ့ ဘာမှမရှိပါဘူး။ ဒါဟာ browser engine တစ်ခုကို ခေါ်ယူပြီး သင့်ဝက်ဘ်စာမျက်နှာကို တင်ပြီးနောက် အကြောင်းအရာကို ခြစ်ထုတ်ပေးတဲ့ ကုဒ်တစ်ခုသာ ဖြစ်ပါတယ်။
တကယ့်အသုံးပြုသူတွေက ဝဘ်ကိုကြည့်ရှုဖို့ ဒီလိုအရာမျိုးကို ဘယ်တော့မှ အသုံးပြုမှာမဟုတ်ပါဘူး။ ခင်ဗျားနဲ့ကျွန်တော်က သတင်းဖတ်ဖို့၊ ဗီဒီယိုကြည့်ဖို့နဲ့ Taobao မှာ ဈေးဝယ်ဖို့ Chrome ကိုဖွင့်ပါတယ် ။ HeadlessChrome က သင့်ရဲ့ဝဘ်စာမျက်နှာကို ဖွင့်ပြီး သင့်ရဲ့ဒေတာတွေကို ခြစ်ထုတ်ပြီး ထွက်သွားပါတယ်။
ဒါကြောင့် HeadlessChrome ဟာ သင့်ရဲ့ statistics backend မှာ traffic ရဲ့ 80% ဒါမှမဟုတ် 90% တောင် ရှိတာကို မြင်တဲ့အခါ ဒီ traffic ဟာ 100% bot traffic ဖြစ်တယ်လို့ ကောက်ချက်ချနိုင်ပါတယ်။
ဒီ bot traffic အားလုံးဘယ်ကလာတာလဲ။
ရိုးရိုးသားသားပြောရရင် အရင်းအမြစ်တွေက အရမ်းကွဲပြားပါတယ်။
အဖြစ်အများဆုံး ဥပမာကတော့ web scraping ပါ။ တချို့ကုမ္ပဏီတွေ ဒါမှမဟုတ် လူပုဂ္ဂိုလ်တွေဟာ headless browser တွေနဲ့ batch scrape web page content တွေကို စတင်ဖို့အတွက် Puppeteer, Playwright ဒါမှမဟုတ် Selenium လိုမျိုး automation framework တွေကို အသုံးပြုကြပါတယ်။ တချို့ကတော့ ထုတ်ကုန်ဈေးနှုန်းတွေ၊ တချို့ကတော့ သတင်းဆောင်းပါးတွေနဲ့ တချို့ကတော့ ပြိုင်ဘက်ဒေတာတွေကို စုဆောင်းကြပါတယ်။
ပြီးတော့ AI ရှိပါသေးတယ်။ အခုဆိုရင် AI tool အမျိုးမျိုး၊ AI search engine တွေနဲ့ AI retrieval system တွေဟာ background မှာ web page တွေကို parsing လုပ်နေကြပါတယ်။ ဆောင်းပါးတစ်ပုဒ်ကို ထုတ်ဝေတဲ့အခါ AI agent အများအပြားက သင့်ရဲ့ content ကို တစ်ပြိုင်နက်တည်း ဖတ်နေနိုင်ပါတယ်။
နောက်ထပ် ပိုသိမ်မွေ့တဲ့ နည်းလမ်းတစ်ခုကတော့ ကိုယ်ပိုင် အချိန်ဇယားဆွဲထားတဲ့ အလုပ်တွေပါ။ ဥပမာ HeadlessChrome ကို အသုံးပြုပြီး နာရီတိုင်း စာမျက်နှာတစ်ခုရဲ့ အဆင့်သတ်မှတ်ချက် ပြောင်းလဲမှုတွေကို စစ်ဆေးပေးတဲ့ SEO စောင့်ကြည့်ရေး script တစ်ခုကို ထည့်သွင်းနိုင်ပါတယ်။ ဒါမှမဟုတ် ဒီ tool ကိုလည်း အသုံးပြုပြီး စာမျက်နှာရဲ့ ဓာတ်ပုံတွေကို အခါအားလျော်စွာ ရိုက်ကူးပေးတဲ့ အလိုအလျောက် screenshot ဝန်ဆောင်မှုတစ်ခုကိုလည်း ထည့်သွင်းနိုင်ပါတယ်။
အစိတ်အနှောင့်အယှက်ဖြစ်စရာအကောင်းဆုံးအမျိုးအစားကတော့ နောက်ဆုံးတစ်ခုပါ- malicious scanning ပါ။ အလိုအလျောက် script တွေက သင့်ဝက်ဘ်ဆိုက်ကို အားနည်းချက်တွေရှိမရှိ scan ဖတ်ဖို့၊ backend login interface ကိုစမ်းသပ်ဖို့နဲ့ spam comment တွေကို အမြောက်အမြားတင်ဖို့ လုပ်ဆောင်ပါတယ်။
စာရင်းအင်း backend က HeadlessChrome ကို ဘယ်လိုခွဲခြားသတ်မှတ်သလဲ။
တကယ်တော့ အတော်လေး ရိုးရှင်းပါတယ်။ browser တိုင်းဟာ webpage တစ်ခုကို ဝင်ရောက်တဲ့အခါ သူတို့ရဲ့ request header မှာ User-Agent field တစ်ခု ပါဝင်ပြီး server ကို "ကျွန်တော်/ကျွန်မ ဘယ်သူလဲ" လို့ ပြောပြပါတယ်။ HeadlessChrome ရဲ့ default User-Agent မှာ "HeadlessChrome" ဆိုတဲ့ string ပါရှိပါတယ်။ ဒီ field ကို parse လုပ်လိုက်တာနဲ့ သင့်ရဲ့ analytics system က ဒါကို သိပါလိမ့်မယ်။
ဒါပေမယ့် web crawler developer က code ကို အနည်းငယ်ပြုပြင်မွမ်းမံပြီး User-Agent ကို ပုံမှန် Chrome ဒါမှမဟုတ် Safari identifier အဖြစ်ပြောင်းလဲမယ်ဆိုရင် statistics backend ကနေ လုံးဝသိနိုင်မှာမဟုတ်ပါဘူး။ ဒါက တကယ့်ခေါင်းကိုက်စရာပါပဲ။
အသုံးပြုပါCloudFlare WAF သည် HeadlessChrome ကို တိကျစွာ ကြားဖြတ်နိုင်သည်
အိုကေ၊ ကျွန်တော်တို့ ပြဿနာကို ဖော်ထုတ်ပြီးပါပြီ။ ဘယ်လိုဖြေရှင်းကြမလဲ။
အတိုက်ရိုက်ဆုံးနှင့် အထိရောက်ဆုံးဖြေရှင်းချက်မှာ CDN သို့မဟုတ် WAF layer ရှိ traffic ကို ကြားဖြတ်ခြင်းဖြစ်သည်။ traffic သည် သင့် server သို့ရောက်ရှိသည်အထိ မစောင့်ပါနှင့်၊ ၎င်းကို လုပ်ဆောင်ပြီးမှ တံခါးဝတွင် ပိတ်ဆို့ပါ။
Cloudflare ကိုအသုံးပြုနေတယ်ဆိုရင် လုပ်ဆောင်ပုံက အရမ်းရိုးရှင်းပါတယ်။
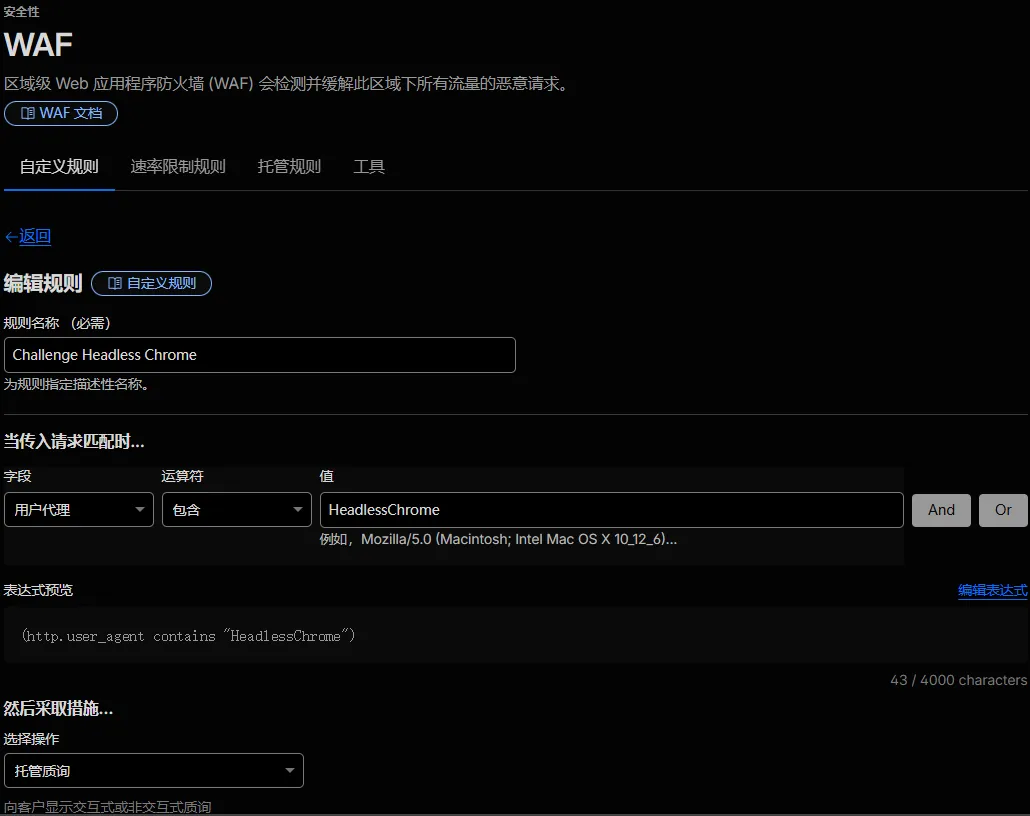
Cloudflare console ထဲကို ဝင်ပါ၊ target domain ကို ရွေးပါ၊ Security ကို ရှာပါ၊ ပြီးရင် WAF ကို နှိပ်ပါ၊ ပြီးရင် Custom Rules ကို သွားပြီး rule အသစ်တစ်ခု ဖန်တီးပါ။
စည်းမျဉ်းအမည်သည် မည်သည့်အရာမဆို ဖြစ်နိုင်သည်၊ ဥပမာအားဖြင့် "Challenge Headless Chrome" နှင့် အလားတူ
မှတ်ထားရုံပါပဲ။
လယ်ကွင်းရွေးချယ်မှုUser Agentအော်ပရေတာ ရွေးချယ်ခြင်းcontains, တန်ဖိုးကို ဖြည့်ပါHeadlessChrome။
ဤအချိန်တွင် သင်သည် preview expression ကို မြင်ရပါမည်၊ ၎င်းသည်http.user_agent contains "HeadlessChrome"
ထို့နောက် လုပ်ဆောင်ချက်တွင် ရွေးချယ်ပါManaged Challengeဒါမှမဟုတ်JS Challenge။
- ရွေးချယ်ဖို့ အကြံပြုချင်ပါတယ်
Managed Challengeအဘယ်ကြောင့်ဆိုသော် ၎င်း၏ အတည်ပြုနည်းလမ်းသည် ပိုမိုဉာဏ်ရည်ထက်မြက်ပြီး တကယ့်အသုံးပြုသူများအပေါ် သက်ရောက်မှုနည်းပါးသောကြောင့်ဖြစ်သည်။
နောက်ဆုံးတွင် Deploy ကို နှိပ်ပါ၊ ဤစည်းမျဉ်းသည် ကမ္ဘာလုံးဆိုင်ရာ စည်းမျဉ်းတစ်ခုအနေဖြင့် အကျိုးသက်ရောက်မှုရှိပါမည်။
Cloudflare မှာ ကမ္ဘာတစ်ဝှမ်းမှာ ဒုတိယအဆင့် ထပ်တူပြုခြင်းနဲ့ ပြင်ဆင်ထားတဲ့ node ရာပေါင်းများစွာ ရှိပါတယ်။ အခြေခံအားဖြင့် headless browser ရဲ့ traffic ကို ခလုတ်ကို နှိပ်လိုက်တာနဲ့ ပိတ်ဆို့သွားပါတယ်။
ကာကွယ်မှုနှင့် အဆင့်မြင့်ကြိုတင်ကာကွယ်မှုတွင် မျက်ကွယ်နေရာများ
သို့သော် "ဒါပေမယ့်" ရှိပါသည်။
User-Agent ကို တွဲစပ်ခြင်းတစ်ခုတည်းဖြင့် မူရင်းဆက်တင်များဖြင့် ဝဘ် crawler ဖွဲ့စည်းမှုအများစုကို ဖြေရှင်းနိုင်ပါသည်။ သို့သော် ကျွမ်းကျင်သော crawler များကို ကိုင်တွယ်ရာတွင် ၎င်းသည် မလုံလောက်ပါ။
Chrome 110 မှစတင်၍ Google သည် headless mode အသစ်ကို မိတ်ဆက်ခဲ့သည်။--headless=newparameter စတင်ခြင်း။ ဤမုဒ်တွင် HeadlessChrome ၏ User-Agent သည် ပုံမှန် Chrome နှင့် တစ်ထပ်တည်းဖြစ်ပြီး ကွာခြားချက်ကို လုံးဝမပြောနိုင်ပါ။
တက်ကြွစွာ လှည့်ဖြားသူများလည်း ရှိပါသည်။ Web crawler developer များသည် User-Agent ကို ကုဒ်တွင် ပုံမှန် Chrome သို့မဟုတ် မိုဘိုင်းဘရောက်ဆာ identifier ဖြင့် တိုက်ရိုက်အစားထိုးထားသောကြောင့် အတိကျဆုံးစည်းမျဉ်းများနှင့်ပင် ကိုက်ညီရန် မဖြစ်နိုင်ပါ။
ဤအခြေအနေအတွက် Cloudflare သည် ဖွင့်နိုင်သော အဆင့်မြင့်အင်္ဂါရပ်နှစ်ခုကိုလည်း ပေးဆောင်ပါသည်။
ပထမတစ်ခုကို Browser Integrity Check လို့ခေါ်ပါတယ်။
ဒီလုပ်ဆောင်ချက်ကိုဖွင့်ဖို့ Security → Settings → Browser Integrity Check ကိုသွားပြီး ခလုတ်ကိုဖွင့်ပါ။
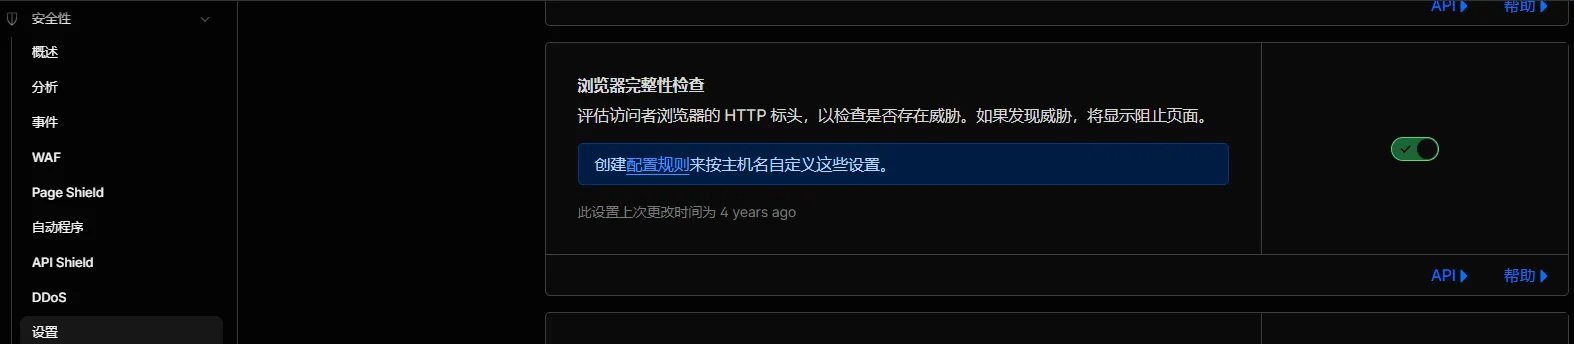
၎င်းသည် TLS လက်ဗွေရာများမှတစ်ဆင့် မူမမှန်သော အသွားအလာကို ဖော်ထုတ်ပေးသည်။ User-Agent ကို မည်မျှပင် ဖုံးကွယ်ထားပါစေ၊ TLS လက်ဗွေရာကို အတုလုပ်၍မရပါ။
ဒုတိယတစ်ခုကို Bot Fight Mode သို့မဟုတ် စက်ရုပ်တိုက်ပွဲမုဒ်ဟုခေါ်သည်။
လမ်းကြောင်းကတော့ Security → Automatic Programs → Bot Fight Mode ဖြစ်ပြီး အဲဒါကိုလည်း ဖွင့်ထားသင့်ပါတယ်။
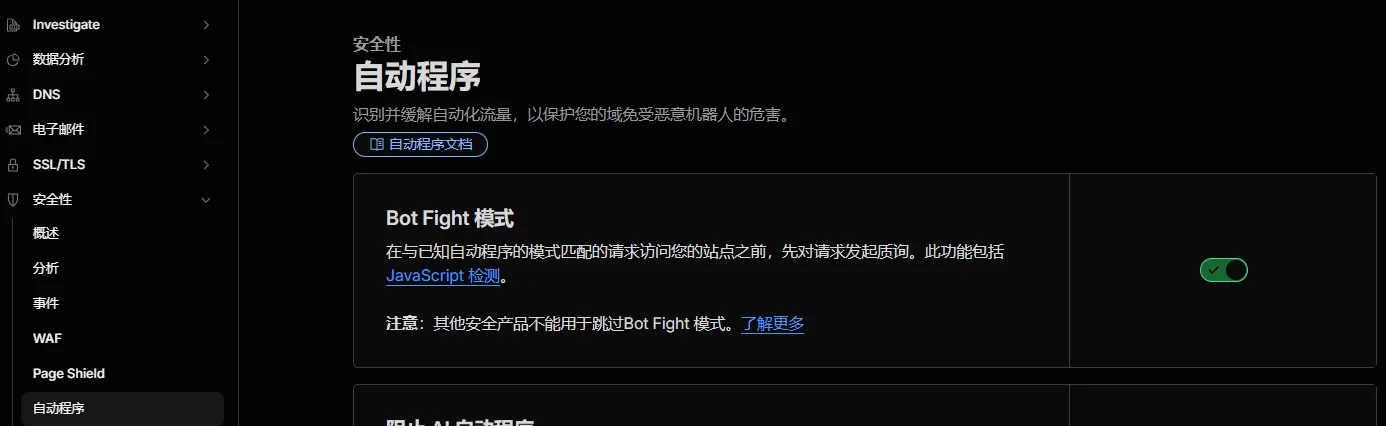
ဒီ feature က traffic ဟာ bot တွေနဲ့ သက်ဆိုင်မှုရှိမရှိ ဆုံးဖြတ်ဖို့အတွက် behavioral characteristics တွေကို ပေါင်းစပ်ထားပါတယ်။ ဥပမာ - request frequency, mouse movement trajectory, page dwell time စတာတွေပါ။
အခမဲ့ဗားရှင်းက သံသယဖြစ်ဖွယ် bot တွေကို စီမံခန့်ခွဲထားတဲ့ စိန်ခေါ်မှုတွေကို အလိုအလျောက် လုပ်ဆောင်ပေးမှာဖြစ်ပြီး၊ အခကြေးငွေပေးရတဲ့ ဗားရှင်းကတော့ ပိုမိုအသေးစိတ်ကျတဲ့ စည်းမျဉ်းဖွဲ့စည်းမှုကို ခွင့်ပြုပါတယ်။
spam မှ web crawler များအထိ၊ တိုက်ခိုက်သူများနှင့် ကာကွယ်သူများအကြား တိုက်ပွဲသည် ဘယ်သောအခါမှ ရပ်တန့်မသွားပါ။
ပြောရင်းနဲ့ ရုတ်တရက် တစ်ခုခုကို သတိရသွားတယ်။
တကယ်တော့၊ ဒီလို ထိုးစစ်ဆင်တာနဲ့ ခုခံကာကွယ်တာတွေဟာ အင်တာနက်သမိုင်းတစ်လျှောက်လုံးမှာ ဖြစ်ပွားနေခဲ့တာပါ။ အစောပိုင်းကာလတွေမှာ spam တွေ ပျံ့နှံ့နေချိန်ကလည်း အတူတူပါပဲ။ သင်က feature တစ်ခုကို ပိတ်ဆို့လိုက်ပြီး ပို့သူက ပြောင်းလဲလိုက်ပါတယ်။ သင်က keyword filtering ကိုသုံးလိုက်တဲ့အခါ ပို့သူက သိမ်မွေ့တဲ့ စကားလုံးတွေကို ခွဲခြမ်းစိတ်ဖြာလိုက်ပါတယ်။ သင်က frequency limit တွေကိုသုံးလိုက်တဲ့အခါ ပို့သူက ပို့တဲ့ frequency ကို လျှော့ချလိုက်ပါတယ်။
ယနေ့ခေတ်တွင် ၎င်းသည် ဝဘ်ဆိုက်များနှင့် ဝဘ် crawler များအကြား တိုက်ပွဲတစ်ခု ဖြစ်လာသည်။ သင်သည် User-Agent filtering ကို အသုံးပြုပြီး တစ်ဖက်က User-Agent ကို အယောင်ဆောင်သည်။ သင်သည် TLS fingerprinting ကို အသုံးပြုပြီး တစ်ဖက်က TLS fingerprint များကို မည်သို့တုပရမည်ကို သုတေသနပြုသည်။
နည်းပညာတွေ ပြောင်းလဲနိုင်ပေမယ့် အခြေခံဂိမ်းသီအိုရီယုတ္တိဗေဒကတော့ ဘယ်တော့မှ မပြောင်းလဲပါဘူး။
သို့သော်၊ ဝဘ်ဆိုက်ပိုင်ရှင်အများစုအတွက်၊ ယခင်အဆင့်ကိုလုပ်ဆောင်ခြင်းသည် လုံလောက်ပါသည်။
headless Chrome traffic ရဲ့ ၈၀% ဟာ default-configuration crawlers တွေကနေ လာတာဖြစ်ပြီး၊ သူတို့က ဖုံးကွယ်ဖို့ ပျင်းရိလွန်းတာကြောင့် WAF rule တစ်ခုတည်းနဲ့ ဖြေရှင်းနိုင်ပါတယ်။ ရှုပ်ထွေးတဲ့ ဖုံးကွယ်မှုတွေရှိတဲ့သူတွေအတွက်ကတော့၊ ကာကွယ်မှုလိုအပ်တဲ့ အထူးအရေးကြီးတဲ့ data တွေ မရှိရင် အလွန်အကျွံ စိတ်ပူစရာမလိုပါဘူး။
လိုအပ်တဲ့ လုပ်ဆောင်ချက်အားလုံးကို ဖွင့်ပြီးတာနဲ့ အခြေခံအားဖြင့် အဆင်သင့်ဖြစ်ပါပြီ။
နောက်ဆုံးအနေနဲ့ နောက်ထပ်အချက်တစ်ခု ထပ်ပြောချင်ပါတယ်။
ဝက်ဘ်ဆိုက်အသွားအလာများလေ ပိုကောင်းလေလို့ လူအများက ယုံကြည်ကြပါတယ်။ ဒါပေမယ့် တကယ့်အသွားအလာနဲ့ bot တွေကို မခွဲခြားနိုင်ဘူးဆိုရင် အဲဒီမြင့်တက်လာတဲ့ ကိန်းဂဏန်းတွေက အဓိပ္ပာယ်မရှိတဲ့ တိုင်းတာမှုတွေပါပဲ။ ဒါတွေက သင့်ရဲ့ ဆုံးဖြတ်ချက်ကိုတောင် လွဲမှားစေပြီး သင့်စာမျက်နှာကို mass-loading လုပ်နေတဲ့ web crawler တစ်ခုသာဖြစ်တဲ့အခါ အချို့သော အကြောင်းအရာတွေက အထူးရေပန်းစားတယ်လို့ ထင်မြင်စေနိုင်ပါတယ်။
ယာဉ်ကြောပိတ်ဆို့မှု၏ စစ်မှန်သောသဘောသဘာဝကို နားလည်ခြင်းသည် ယာဉ်ကြောပိတ်ဆို့မှုကိန်းဂဏန်းများကို လိုက်လံရှာဖွေခြင်းထက် များစွာပိုအရေးကြီးပါသည်။
ဝက်ဘ်ဆိုက်တွေကို ဦးစီးလုပ်ကိုင်နေတဲ့ ဒါမှမဟုတ် SEO လုပ်နေတဲ့ သူငယ်ချင်းတွေရှိရင် ဒီဆောင်းပါးကို သူတို့ဆီ ပို့ပေးလို့ရပါတယ်။ လူအများစုက သူတို့ရဲ့ ဝက်ဘ်ဆိုက်တွေကို bot အများအပြားက တိုက်ခိုက်နေတယ်ဆိုတာ မသိကြသလို ဒီပြဿနာကို ဖြေရှင်းဖို့ကလည်း တကယ်ကို ရိုးရှင်းတယ်ဆိုတာလည်း မသိကြပါဘူး။
ဒီအထိဖတ်ပြီးပြီဆိုတော့ အသုံးဝင်ရင် like လုပ်ပြီး share လုပ်ပေးပါ။ update တွေကို ဦးစွာရယူချင်ရင် ကျွန်တော့်ကို follow လုပ်နိုင်ပါတယ်။
ကျွန်တော့်ရဲ့ဆောင်းပါးကို ဖတ်ရှုပေးတဲ့အတွက် ကျေးဇူးတင်ပါတယ်။ နောက်တစ်ကြိမ်မှာ ပြန်ဆုံကြမယ်။
Chen Weiliang ရဲ့ဘလော့ဂ် ( https://www.chenweiliang.com/ ) မှာ မျှဝေထားတဲ့ "HeadlessChrome ရဲ့ ပုံမှန်မဟုတ်တဲ့ Traffic Explosion? Cloudflare ရဲ့ 3-Step Guide (WAF Rules တွေနဲ့) ကို လုံးဝပိတ်ဆို့နည်း" ဆောင်းပါးက သင့်အတွက် အထောက်အကူဖြစ်လိမ့်မယ်လို့ မျှော်လင့်ပါတယ်။
ဒီဆောင်းပါးလင့်ခ်ကို မျှဝေပေးဖို့ မတွန့်ဆုတ်ပါနဲ့- https://www.chenweiliang.com/cwl-34500.html