
ไดเรกทอรีบทความ
การรวบรวมบทความแบบธรรมดานั้นเรียบง่ายแต่ยากสำหรับนักสะสมรถไฟความเร็วสูง (รถไฟ) ในการรวบรวมเพจ JS และโฟลว์น้ำตก การคลิก JavaScript ที่โหลดและการดร็อปโหลดหน้ารายการที่คล้ายกับ Ajax ทำให้สามเณรจำนวนมากไม่สามารถเริ่มต้นได้
บล็อก ของ Chen Weiliangจะแชร์วิธีการใช้ตัวเก็บข้อมูลรถไฟความเร็วสูงเพื่อรวบรวมรายการต่างๆ โดยใช้การแบ่งหน้าด้วย JavaScript และการโหลดข้อมูลแบบคลิกเพื่อโหลดด้วย AJAX
ตัวรวบรวมรถไฟรวบรวม URL ของหน้าเนื้อหาและเขียนใน JS
ขั้นแรก คุณต้องดักจับข้อมูลการรับส่งเครือข่ายจากหน้าเว็บเป้าหมาย สำหรับเว็บไซต์ที่ไม่ซับซ้อน คุณสามารถดึงข้อมูล JSON ได้ แต่สำหรับเว็บไซต์ที่ซับซ้อนกว่า คุณจะต้องใช้วิธี POST และกรอกข้อมูลคุกกี้ ค่าสุ่ม ฯลฯ เช่นข้อมูลจาก Mogujieเป็นต้น
- ง่ายกว่าในการวิเคราะห์การแบ่งหน้า JS โดยไม่ต้องดักจับแพ็กเก็ต เช่น URL ในหน้าที่สองของผลการค้นหาวิดีโอของ Tencent
cur=2 - ตัวเลขเบื้องหลัง
2คือการตั้งค่า "Start URL Addition Wizard" → "Batch URL" → "Address Format"[พารามิเตอร์ที่อยู่]
นี่คือตัวรวบรวมหัวรถจักรอย่างง่ายวิธีรับเนื้อหาของการโทร JS โดยยกตัวอย่างเครือข่ายเปลือกผลไม้
นักสะสมรถจักรรถไฟความเร็วสูงรับเนื้อหาของการโทร JS ได้อย่างไร
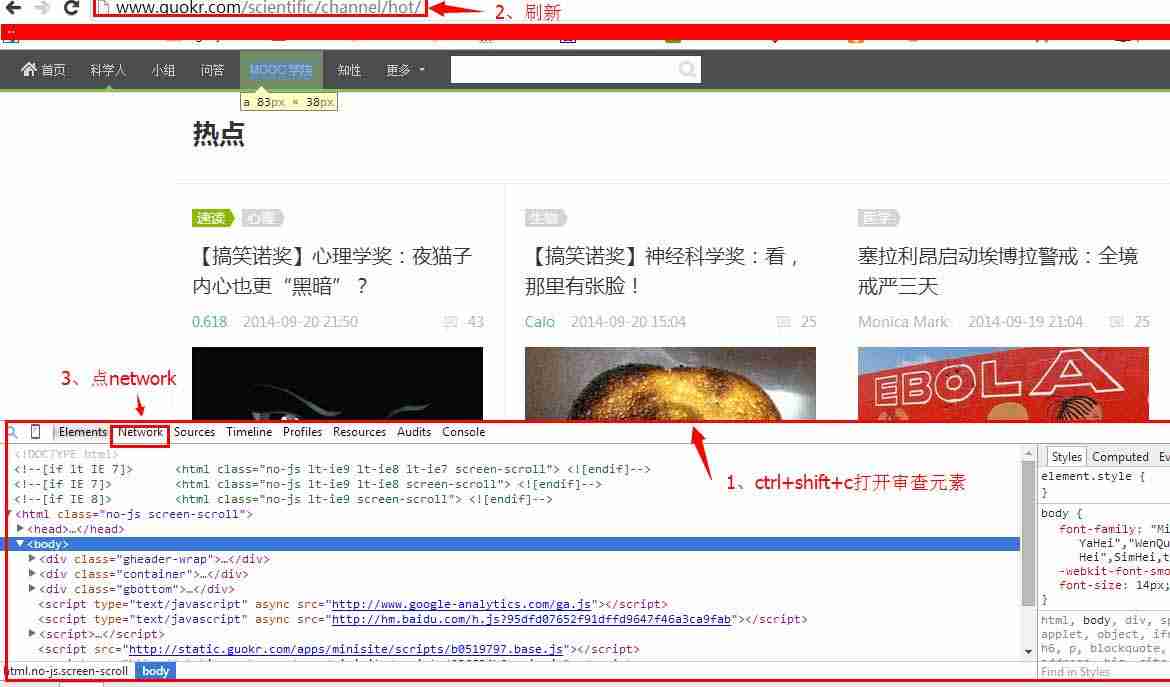
สิ่งแรกที่คุณต้องใช้คือเบราว์เซอร์ Chrome ▼

1. คลิกแรกบนหน้าเป้าหมายF12或Ctrl+Shift+Cเปิดองค์ประกอบตรวจสอบแล้วคลิกแท็บเครือข่าย ▼
2. คลิกปุ่ม XHR เพื่อทริกเกอร์การโหลดอาแจ็กซ์บนหน้า และเบราว์เซอร์จะตรวจสอบการทำงานและการเปลี่ยนแปลงของข้อมูลหน้า▼
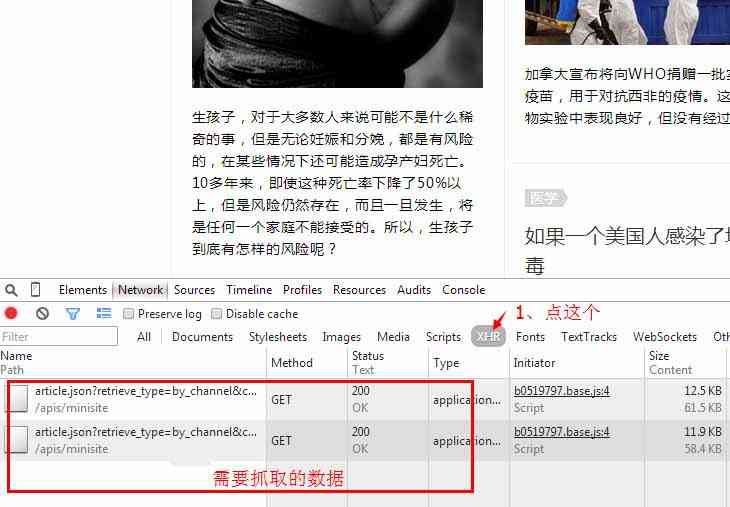
กล่องสีแดงคือที่อยู่ของข้อมูลที่จับได้▲
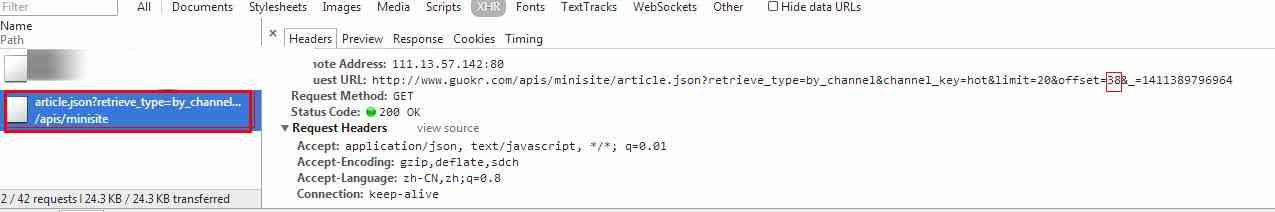
3. คลิกที่อยู่ข้อมูล และข้อมูลรายละเอียดจะปรากฏขึ้นทางด้านขวาให้ความสนใจกับกฎหมายของ URL ที่อยู่คำขอตัวอย่างเช่น ในรูปด้านล่าง มีการประทับเวลาและหมายเลขหน้า ▼
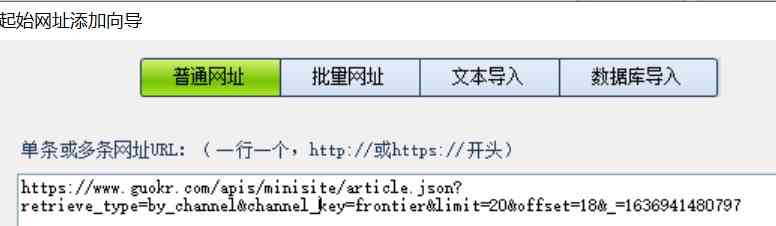
4. เพิ่มที่อยู่ที่บันทึกต่อไปนี้ในตัวรวบรวมรถไฟ และตั้งค่ากฎที่อยู่ จากนั้นตั้งค่าตัวรวบรวมรถไฟปกติ▼
หวังว่า บทความ "วิธีการรวบรวมเนื้อหาจากรายการ AJAX ที่ใช้การแบ่งหน้า/คลิกเพื่อโหลดด้วย JavaScript โดยใช้ตัวรวบรวมข้อมูลจากรถไฟความเร็วสูง" ที่เผยแพร่ในบล็อกของ Chen Weiliang ( https://www.chenweiliang.com/ ) จะเป็นประโยชน์กับคุณ
โปรดแชร์ลิงก์บทความนี้ได้ตามสบาย: https://www.chenweiliang.com/cwl-1906.html